FlashAttention 원리: 타일링과 GPU 메모리 접근 최적화
목차
2026년 10월 14일 보완: 미완성으로 남겨둔 타일링·softmax 설명을 정리하고, 원 논문과 PyTorch 공식 문서를 추가했다. 아래 내용은 2022년 FlashAttention 논문의 기본 원리이며, 후속 버전의 구현이나 성능을 직접 측정한 결과는 아니다.
FlashAttention은 무엇을 개선하나?
FlashAttention은 attention 연산에서 GPU의 HBM과 온칩 SRAM 사이의 데이터 이동을 줄이는 알고리즘이다. Q, K, V를 작은 블록으로 나누어 계산하고, 전체 attention 행렬을 HBM에 저장하지 않는다. 원 논문은 이를 IO-aware exact attention이라고 설명한다. 근사 attention으로 계산 대상을 줄이는 방식이 아니라, 같은 attention을 메모리 계층에 맞게 계산하는 방식이다. 다만 부동소수점 연산 순서에 따라 수치적인 차이는 생길 수 있다.[1][2]
저는 현재 LLM을 포함한 AI 모델, 그리고 이를 효율적으로 처리하기 위한 NPU/GPU 관련 업무들을 다양하게 진행해 오고 있습니다. 이 논문에 관심을 가진 것도 모델을 사용하는 비용을 어떻게 줄일 수 있을지 궁금했기 때문입니다. 연산량뿐 아니라 데이터를 가져오고 저장하는 비용까지 봐야 한다는 점이 흥미로웠습니다.
일반적인 dense self-attention은 시퀀스 길이가 길어질수록 계산량과 attention 행렬의 크기가 제곱에 비례해 커진다. FlashAttention은 이 중 큰 중간 행렬을 메모리에 저장하는 문제를 다룬다. Dense attention 자체의 제곱 계산량을 선형으로 바꾸는 알고리즘은 아니다.[1]
GPU 메모리 계층과 HBM 접근
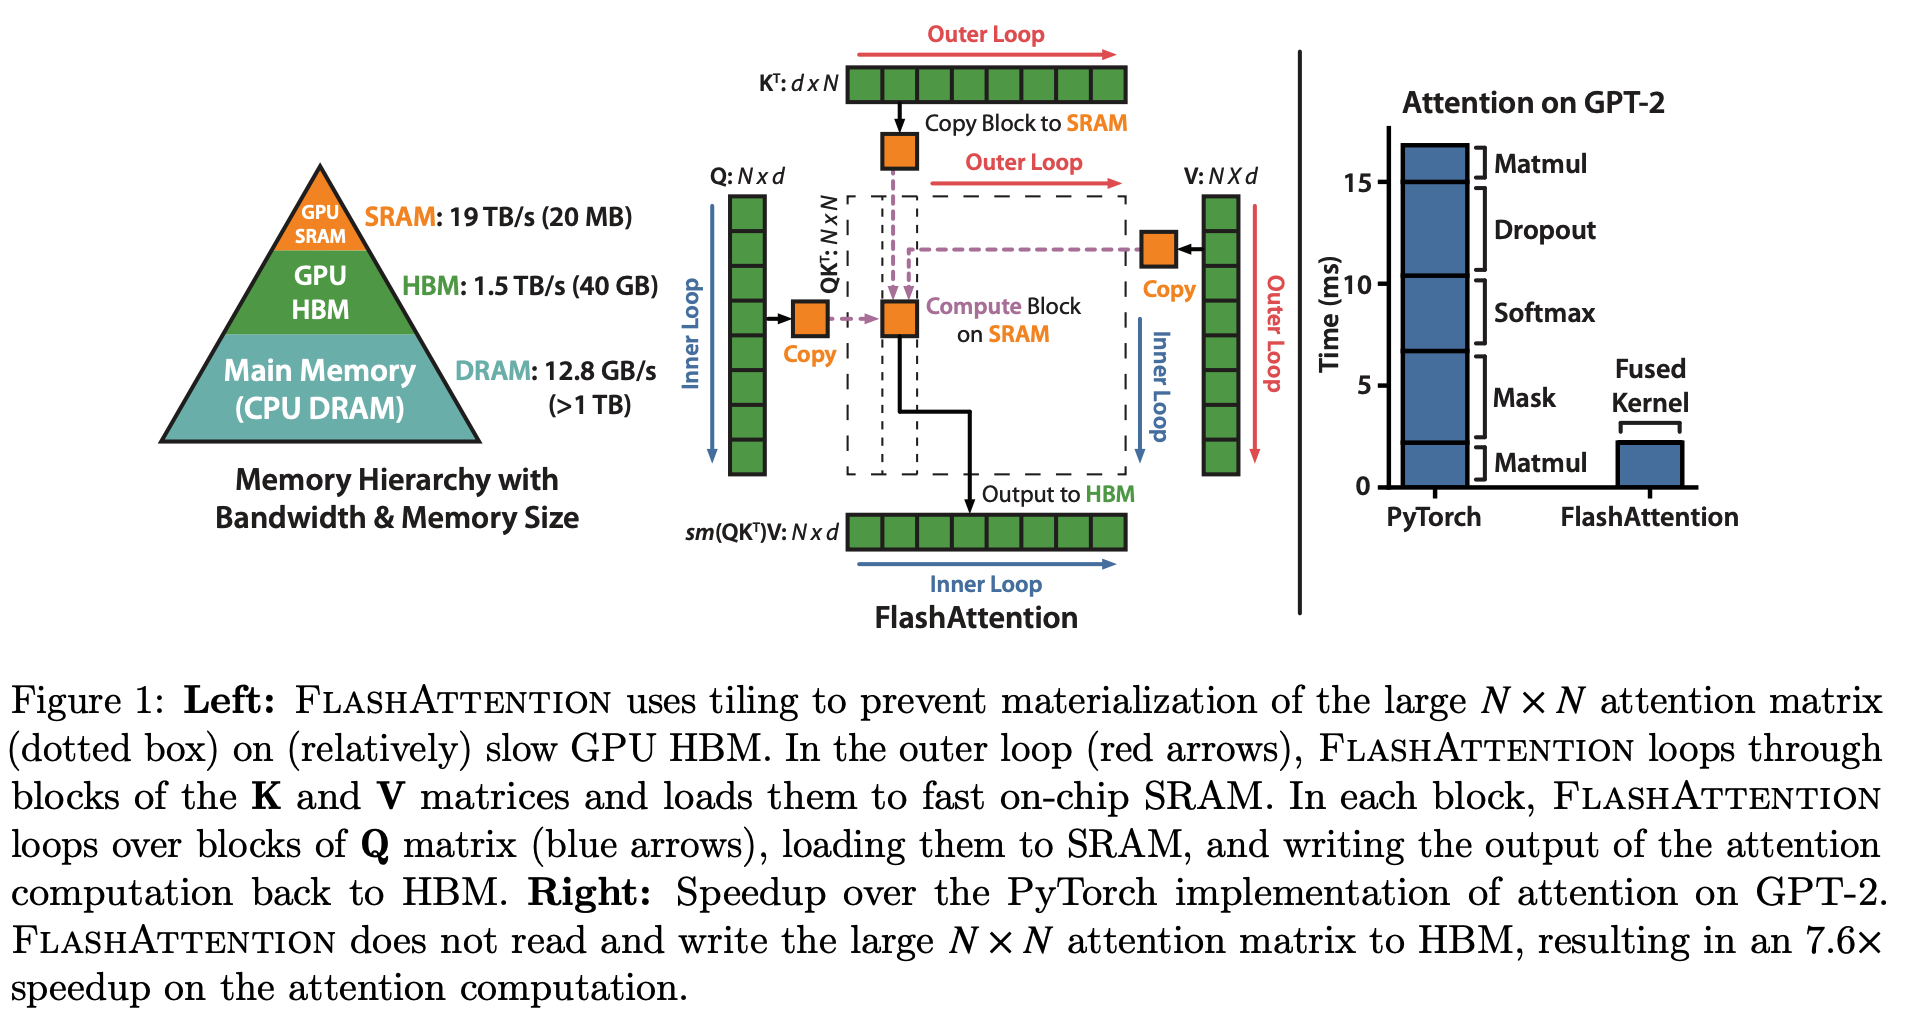
그림 출처: Dao 외, FlashAttention 논문.[1]
GPU의 HBM은 큰 데이터를 담을 수 있지만, 연산 장치 가까이에 있는 온칩 SRAM보다 접근 비용이 크다. SRAM은 빠른 대신 용량이 작다. 따라서 전체 데이터를 한 번에 올릴 수는 없고, 일부를 가져와 계산하고 결과를 다시 저장해야 한다.
기본적인 attention 구현은 Q와 K의 곱으로 점수 행렬을 만들고, softmax를 적용한 뒤 V와 곱한다. 이때 큰 중간 행렬을 HBM에 쓰고 다시 읽으면 데이터 이동이 병목이 될 수 있다. FlashAttention은 이 중간 결과를 작은 블록 단위로 처리해 HBM 왕복을 줄인다.[1]
타일링은 HBM 접근을 어떻게 줄이는가?
타일링(tiling)은 Q, K, V를 SRAM에 들어갈 크기의 블록으로 나누는 방법이다. 한 블록을 읽은 뒤 attention 점수 계산, softmax, V와의 곱을 이어서 수행한다. 이렇게 연산을 결합하면 중간 행렬을 매번 HBM에 쓰고 읽을 필요가 줄어든다.[1]
다만 softmax는 한 행 전체의 정규화 값이 필요하다. 블록마다 따로 softmax를 계산해 결과를 단순히 합치는 것으로는 원래 attention과 같은 결과를 얻을 수 없다. FlashAttention은 블록을 순회하면서 행별 최댓값과 지수합을 갱신하는 온라인 softmax를 사용한다. 새 블록의 최댓값을 반영해 기존 누적값을 다시 보정하므로, 전체 점수 행렬을 저장하지 않고도 정규화된 출력을 계산할 수 있다.[1]
순서를 요약하면 다음과 같다.
- Q, K, V의 일부 블록을 HBM에서 SRAM으로 읽는다.
- 블록의 attention 점수를 계산하고, 행별 최댓값과 지수합을 갱신한다.
- 기존 출력 누적값을 보정하고 현재 블록의 V 기여분을 더한다.
- 필요한 블록을 모두 순회한 뒤 최종 출력을 HBM에 저장한다.
역전파에서도 전체 attention 행렬을 보관하는 대신 필요한 값을 다시 계산한다. 계산을 일부 더 하더라도 HBM 접근을 줄여 전체 실행 시간을 낮추는 선택이다.[1]
SRAM 크기가 커지면 항상 빨라질까?
SRAM에 더 큰 타일을 담을 수 있으면 데이터 재사용을 늘리고 HBM 접근을 줄일 여지가 있다. 원 논문은 SRAM 크기에 따른 IO 복잡도를 분석하고, 일정 범위에서 FlashAttention의 IO 효율성을 설명한다.[1]
그렇다고 SRAM 용량만으로 실제 속도를 결정할 수는 없다. 타일을 크게 잡으면 스레드 블록이 사용하는 shared memory와 레지스터가 늘어 동시 실행 가능한 블록 수가 줄어들 수 있다. 시퀀스 길이, head dimension, 자료형, GPU 구조도 함께 영향을 준다. 구체적인 최적 타일 크기와 속도는 대상 GPU에서 측정해야 한다. 이 글에는 직접 수행한 벤치마크가 없다.
PyTorch에서도 사용할 수 있나?
2026년 10월 14일 확인한 PyTorch 공식 문서의 torch.nn.functional.scaled_dot_product_attention은 FlashAttention-2를 포함한 여러 구현을 지원한다. CUDA에서는 입력 조건과 백엔드 설정에 따라 최적화된 커널을 선택할 수 있으며, 모든 입력에서 FlashAttention이 실행되는 것은 아니다.[2]
따라서 예전 초안의 “PyTorch에서는 지원하지 못한다”는 설명은 현재 상태와 맞지 않는다. 직접 커널을 선택하거나 성능을 비교할 때는 사용 중인 PyTorch 버전, GPU, 자료형과 입력 제약을 공식 문서에서 확인해야 한다.
관련 글과 참고 자료
- LLaDA와 Gemini Diffusion: 자기회귀 언어 모델과의 차이: attention 구현 최적화와 별개로, 텍스트를 생성하는 방식 자체를 바꾸는 접근을 정리한 글.
- [1] Tri Dao 외, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, 2022. 타일링·온라인 softmax·역전파 재계산과 IO 복잡도 분석의 원 출처.
- [2] PyTorch, scaled_dot_product_attention 공식 문서. 지원 구현, 자동 커널 선택과 제약 조건. 2026년 10월 14일 확인.