LLaDA와 Gemini Diffusion: 자기회귀 언어 모델과의 차이
목차
2026년 10월 14일 보완: 2025년 6월의 학습 기록을 바탕으로 학습 방식과 생성 속도에 대한 설명을 바로잡고 출처를 추가했다. 당시 대기 명단 이야기는 현재 신청 가능 여부를 의미하지 않는다.
LLaDA는 자기회귀 LLM과 무엇이 다른가?
LLaDA는 일부 토큰을 마스킹한 텍스트에서 가려진 토큰을 예측하도록 학습하는 diffusion 언어 모델이다. 생성할 때도 마스크로 시작해 토큰을 채우고 반복적으로 갱신한다. 앞에서부터 다음 토큰을 순서대로 예측하는 자기회귀 모델과 이 점이 다르다. 토큰 블록을 병렬로 다룰 수 있지만, 모든 문장을 한 번의 연산으로 완성하는 것은 아니다.[1]
| 비교 항목 | 자기회귀 언어 모델 | LLaDA |
|---|---|---|
| 기본 학습 목표 | 앞선 문맥으로 다음 토큰 예측 | 마스킹된 토큰 복원 |
| 생성 방식 | 앞에서부터 토큰을 순차적으로 추가 | 마스크에서 출발해 여러 단계로 복원 |
| 생성 비용을 볼 때 | 출력 길이, KV cache, 모델·하드웨어 조건 | 출력 길이, 복원 단계 수, 모델·하드웨어 조건 |
아래 Gemini Diffusion은 같은 텍스트 diffusion 계열의 별도 모델이다. Google DeepMind의 공개 소개만으로 LLaDA와 내부 구조나 학습 방식이 같다고 단정할 수는 없다.[2]
처음 접했을 때의 기록
2025년 6월, Gemini Diffusion의 대기 명단을 계기로 Large Language Diffusion Models 논문을 함께 읽어보기로 했다.
- Paper: Shen Nie 외, Large Language Diffusion Models, arXiv:2502.09992, 2025.[1]
- Gemini Diffusion: Gemini Diffusion - Google DeepMind
Large Language Diffusion Models (LLaDA) 을 처음 접한 것은 안될공학 유튜브였던 것 같다. 간단하게 설명하면 Image Diffusion 기술을 응용하여 언어 모델을 diffusion 방식으로 생성하는 아이디어이다.
당시 이미 상용화 수준으로 서비스를 하는 회사도 있었다. 그 후 불과 3개월만에 Google 에서도 diffusion 모델을 출시 한 것이다.
기술 산업은 정말 경쟁이 치열하다는 생각도 들고, 선다 피차이가 말했던 2등 전략이 어쩌면 이런 치열한 경쟁에서 살아남는 현명한 전략일지도 모른다는 생각이 든다.
논문 리뷰: 마스킹과 반복 복원
What is now proved was once only imagined. —William Blake
재미있게도 논문은 위의 인용구로부터 시작된다.
많은 언어 모델은 Auto-Regressive Modeling(ARM) 방식으로 토큰을 생성한다. 앞선 문맥과 지금까지 생성한 토큰을 조건으로 다음 토큰을 예측하는 방식이다.
자기회귀 방식에서는 다음 토큰이 앞서 생성한 토큰에 의존하므로 순차적인 생성이 필요하다. 문맥 길이의 제한은 이 생성 순서와는 별도의 문제이며, diffusion을 사용한다고 자동으로 없어지는 것은 아니다.
저자는 이러한 ARM 의 단점을 보고, 다른 방법을 써도 괜찮은지 고민한 것 같다. Large language model 은 출력된 언어의 distribution 을 모델링 하는 것이기 때문에, distribution 을 잘 생성하는 검증된 방법인 diffusion 방법을 적용한다. LLM 의 여러 특성들은 언어모델 자체의 특성이며, ARM 이 수행하는 무손실 압축 특성은 다른 확률 모델로도 충분히 수행할 수 있다고 말한다.
이미지 diffusion 모델은 노이즈로부터 이미지를 생성하는 과정을 학습한다. 이를 통해 요청된 쿼리로부터 노이즈를 적당하게 생성하고 이로부터 다양하고 높은 퀄리티의 이미지를 만들어 내는 일을 수행한다. 그 과정은 diffusion 이라는 말이 의미 하듯이 노이즈를 점차 제거해 나가는 과정을 통해서 진행된다. (diffusion 의 forward 과정에서는 학습데이터이에 점차 노이즈를 확산시키며 학습할 데이터를 만들고 reverse 과정을 통해 노이즈로 부터 원래의 학습 데이터를 추정하는 방법을 배운다. 엄밀히 말하면 reverse diffusion 을 통해 노이즈를 제거한다.)
이미지 생성을 위해 사용되던 Diffusion 방법을 언어모델에 적용한 것이 LLaDA 이다.
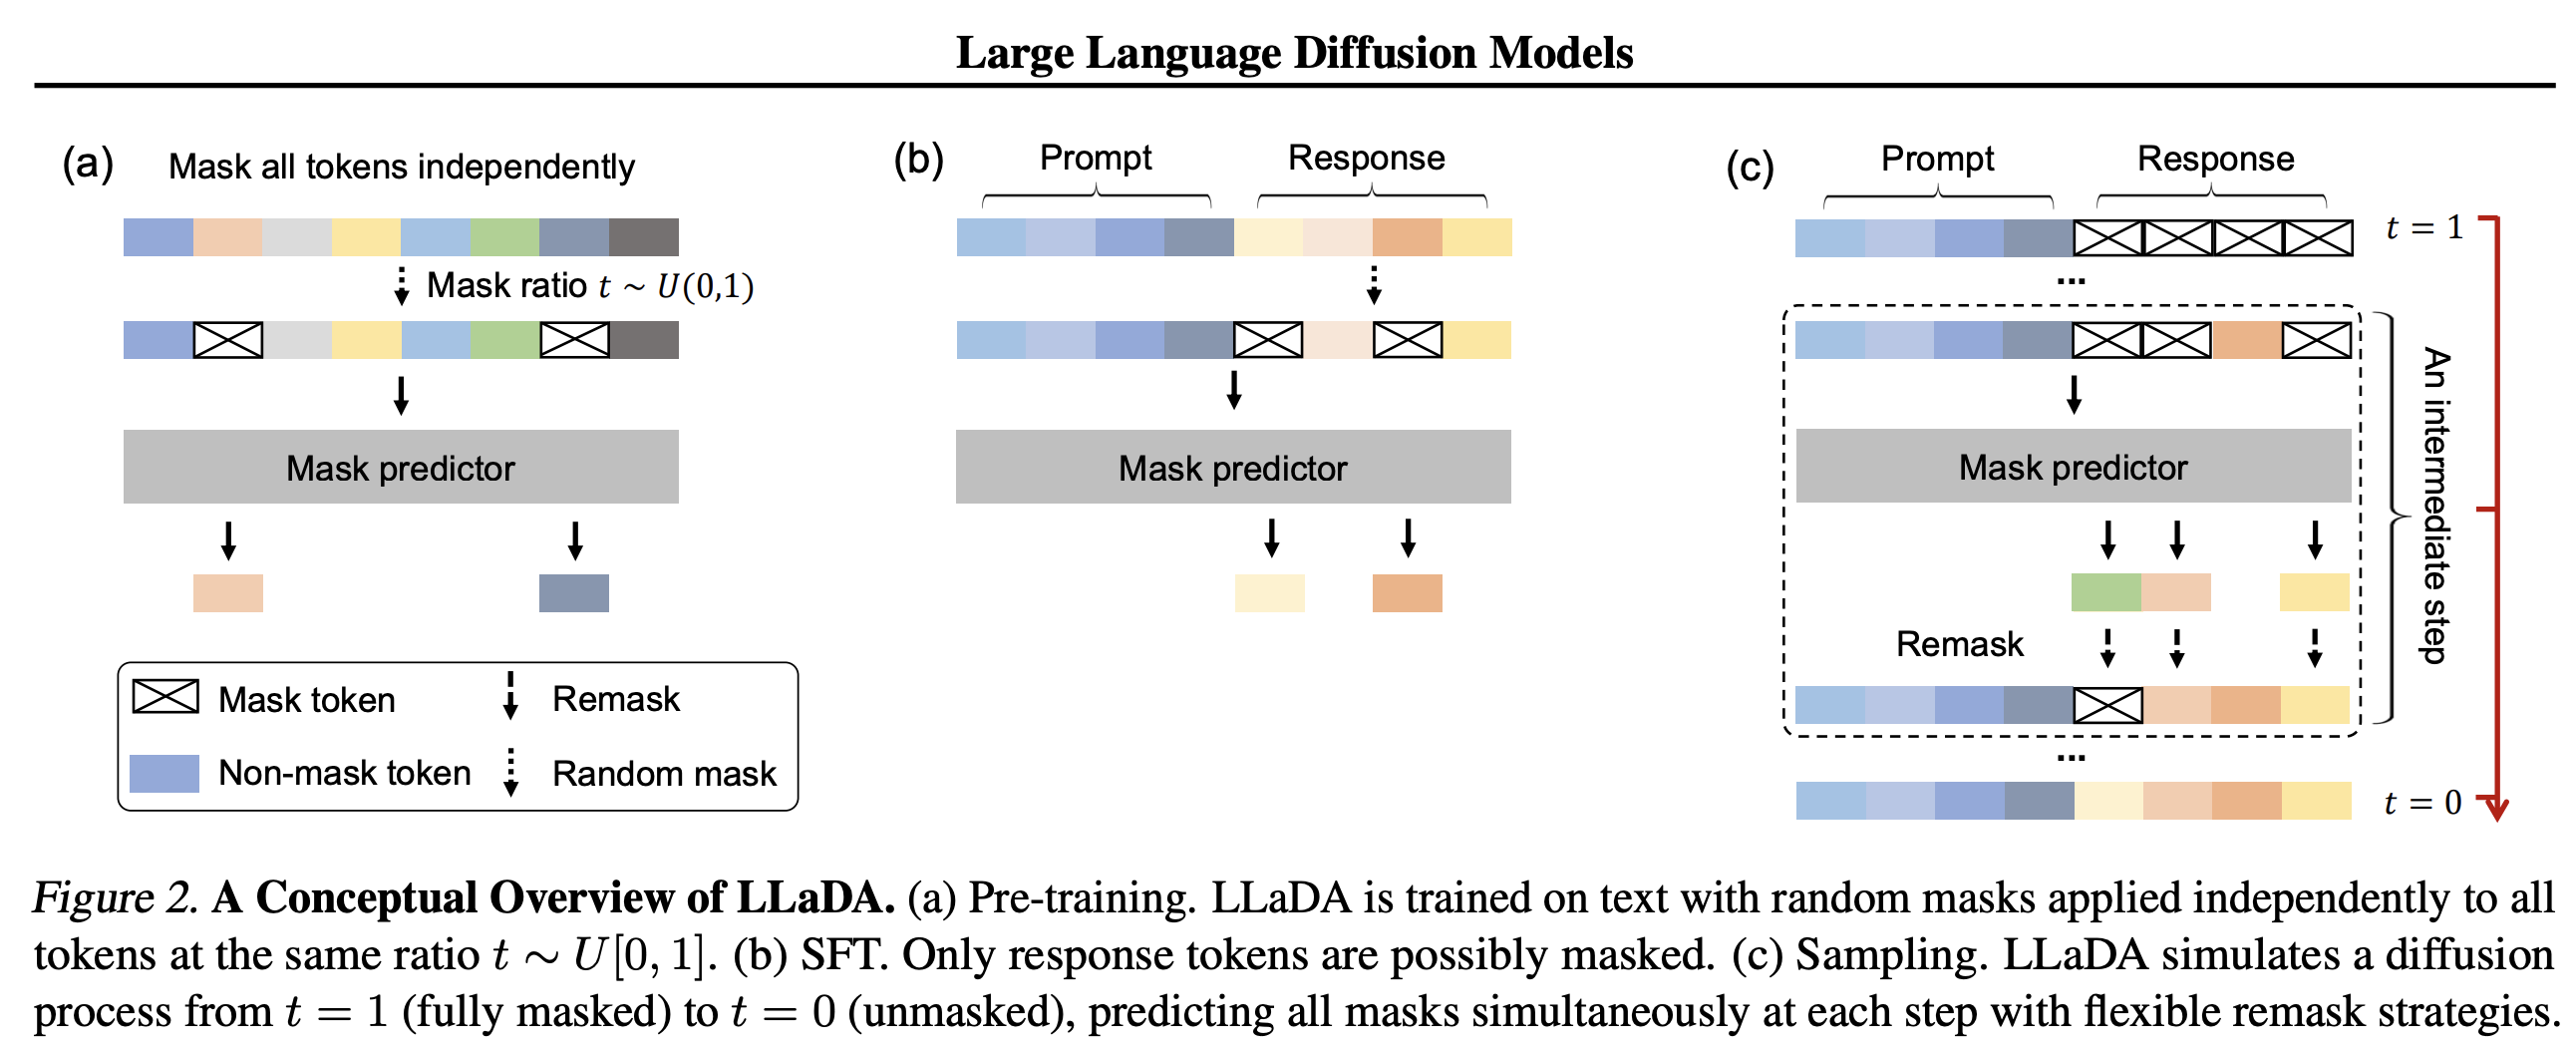
그림 출처: Large Language Diffusion Models 논문.[1]
논문의 그림이 쉽게 잘 그려진 것 같다. (a) Pre-training에서는 텍스트의 일부 토큰을 마스킹하고 이를 복원하는 mask predictor를 학습한다. (b) SFT에서는 prompt를 조건으로 두고 response의 마스킹된 토큰을 예측하도록 학습한다. Pre-training과 SFT라는 큰 단계는 자기회귀 LLM과 비슷하지만, 다음 토큰 예측과 마스킹 복원은 서로 다른 학습 목표다. 차이가 추론에만 있는 것은 아니다.
(c) Inference에서는 생성 영역의 마스크를 여러 단계에 걸쳐 복원한다. 원 논문의 이미지 diffusion 설명과 연결해서 이해할 수는 있지만, LLaDA가 다루는 것은 이미지의 연속적인 가우시안 노이즈가 아니라 이산 토큰의 마스킹 과정이다.[1]
Gemini Diffusion의 공개 정보와 비교할 점
Google DeepMind는 Gemini Diffusion을 실험적인 텍스트 diffusion 모델로 소개한다. LLaDA를 그대로 상용화한 모델이라는 근거는 공개 소개에서 확인할 수 없다.[2]
Large Language Model, Image Diffusion, Large Language Diffusion 모두 이미 발표되었던 기술이어서 Google DeepMind가 이를 어떤 수준의 제품으로 발전시킬지 궁금하다.
Diffusion은 여러 토큰을 병렬로 갱신할 수 있어 생성 속도를 높일 여지가 있다. 다만 반복 복원 횟수와 모델 크기, 출력 길이, 하드웨어에 따라 비용이 달라지므로 자기회귀 방식보다 항상 빠르다고 말할 수는 없다. Google DeepMind의 공개 속도 수치도 해당 평가 조건에서의 결과이며, 직접 측정한 수치는 아니다.[1][2]
한편으로 개인적으로는 드는 생각은 사용자 인터페이스 측면에서 ARM 방법은 LLM 이 생각을 하는 듯한 인상을 주기 때문에 좀 더 사람에게 친화적일 수 있을 것 같다. Demo 영상을 보면 Diffusion 모델은 그렇지는 않다. 상당히 기계적인 생성 과정으로 보인다. Diffusion 과정 자체가 사람들의 인지하기 좋은 방법은 아니기 때문이다.
아주 빠른 속도가 공학적으로는 더 좋은 결과일지도 모르지만 수년간 애플은 사용자의 심리적, 인지적 반응이 공학적으로 얼마나 중요한지 보여주었다. 대중이 어떻게 받아들일지가 궁금한 포인트이다.
Reasoning 을 통한 성능향상이 가능할지도 궁금하다. LLM 이 그랬던 것처럼 Diffusion 모델도 Reasoning 을 통해 성능 향상이 가능할지가 중요한 포인트 일 것 같다. 최근 OpenAI 에서 ChatGPT 의 새버전을 발표했는데 여러 벤치마크에서는 더 좋은 성능을 보여주었지만 환각 현상과 아부하는 현상이 심해서 버전을 roll-back 하는 초유의 사태도 있었다. 학습 과정에서 사용자 응답을 너무 많이 반영한 결과라고 하였지만 나는 개인적으로는 reasoning 과 같은 장치를 통해 이런 문제를 해결 할 것 같다는 생각이 든다.
원 논문은 LLaDA의 스케일링 실험도 제시한다. 모델이 작다는 인상만으로 scaling law가 적용되지 않는다고 판단할 근거는 없다. 앞으로는 모델과 학습 데이터를 늘릴 때의 품질, 복원 단계에 따른 생성 비용, 실제 사용성을 함께 봐야 할 것 같다.[1]
관련 글과 참고 자료
- FlashAttention 원리: 타일링과 GPU 메모리 접근 최적화: 생성 방식의 변경과는 별개로, attention 연산의 데이터 이동을 줄이는 접근.
- [1] Shen Nie 외, Large Language Diffusion Models, 2025. 마스킹 기반 학습, SFT, 역방향 생성과 스케일링 실험.
- [2] Google DeepMind, Gemini Diffusion 공식 소개. 실험 모델의 성격, 생성 방식과 공개 벤치마크. 2026년 10월 14일 확인.